はじめまして。食べログカンパニー開発本部 飲食店プロダクト開発部 食べログノートチームの中内です。
本記事では、対話型をやめて1度実装タスクを指示することでPRまで作成するAIエージェントパイプラインを自作し、チームで運用した記録を紹介します。このAIエージェントパイプラインは、人間の開発フローに沿って動きます。PR1本分のトークン数と金額、所要時間の実測を示しながら、対話型よりも並行して作業を進めやすくなった手応えをまとめます。あわせて、約2週間チームで運用した実績も書きます。
目次
- なぜ「実装タスクを渡すだけでPRまで作るAIエージェントパイプライン」を作ったのか
- 仕組みの全体像:5エージェントによるリレー
- 実装タスクの書き方:曖昧さを防ぐ指示テンプレート
- コストの実態:所要時間とトークン数
- コストだけでは測れない価値
- チームで運用してみた実績
- まとめ
- 最後に
なぜ「実装タスクを渡すだけでPRまで作るAIエージェントパイプライン」を作ったのか
私たちが開発している食べログノートは、レストラン向けのオンライン予約台帳です。ネット予約、電話予約、ウォークインの管理、顧客管理、卓管理などを一元的に行えます。
食べログノートの開発でもAIが導入され、対話しながら進めることで、既に実装スピードは以前より上がっていました。しかし、並列に扱うタスクが増えるほど、人間とAIのやり取りの往復が積み重なり、人間の返答待ちがボトルネックになっていました。
逐一指示を出す対話から脱却し、人間の返答待ちをなくせないか、というのが今回の出発点です。そこでAIエージェントパイプラインを構築しました。実装タスクを渡すだけで、途中で対話をすることなく、詳細設計・実装・セルフレビューまで進み、PRを作成します。
設計や実装をAIにさせるだけではありません。複数のエージェントがお互いの成果物をレビューし合う仕組みも組み込み、人間が最終的な承認だけで済む状態を目指しました。
仕組みの全体像:5エージェントによるリレー
このAIエージェントパイプラインでは、5つの専門役割に分かれたエージェントがリレー形式で作業を引き継ぎ、PRを作成します。
- director(詳細設計エージェント):実装タスクの内容から詳細設計書を作成する
- curator(詳細設計レビューエージェント):設計書の妥当性をレビューする
- artist(実装エージェント):設計書をもとに実装し、コミットする
- critic(技術的観点レビューエージェント):実装の技術的な品質(バグ・セキュリティ・型安全性・規約)をレビューする
- editor(要件的観点レビューエージェント):実装が設計書の意図通りかをレビューする
AIエージェントパイプラインが実装タスクを受け取ってからPRを作成するまでの流れ
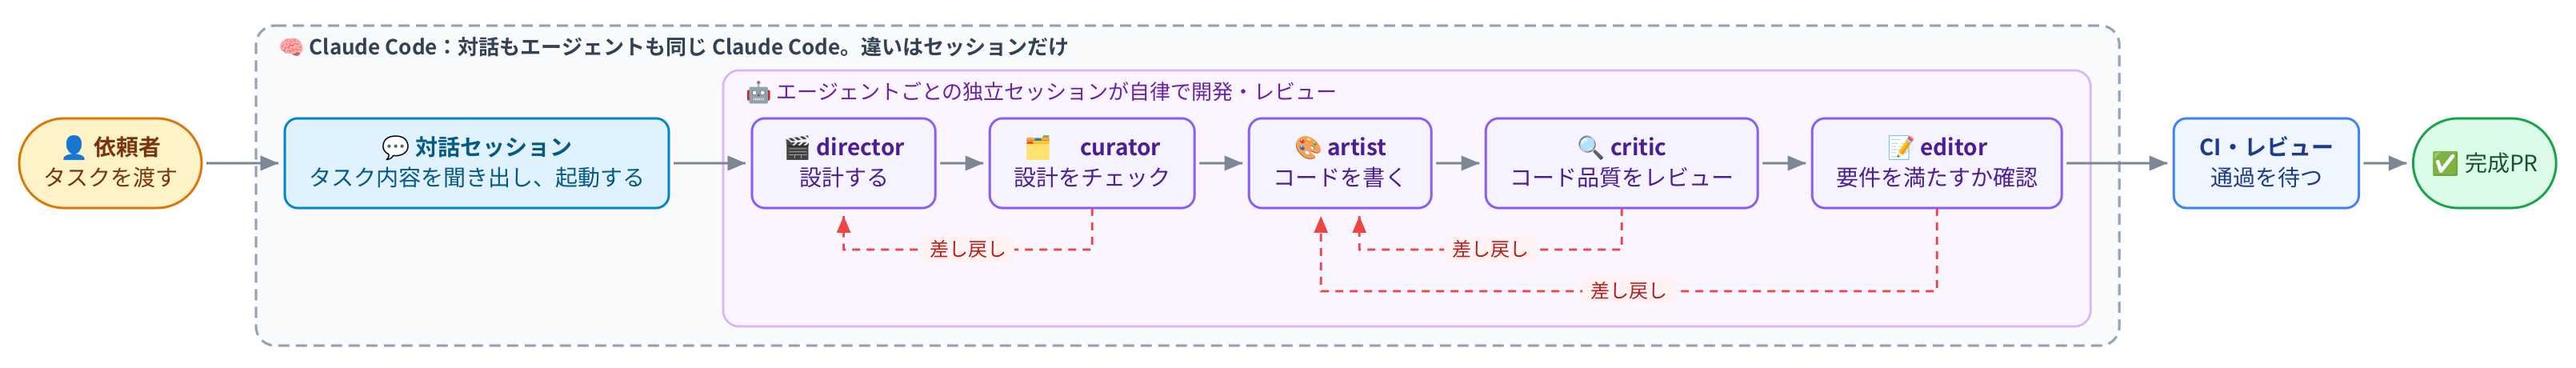
Claude Codeからスキルを呼び出すと、実装タスクの内容やベースブランチを人間から聞き出します。そのうえで、AIエージェントパイプラインを起動します。起動したあとは、そのセッションでの人間とClaude Codeとのやり取りはいったん終了です。以降、このセッションで受け取るのは、AIからの質問とエージェントの作業完了通知だけです。人間は、同じセッションで他の作業を進められます。
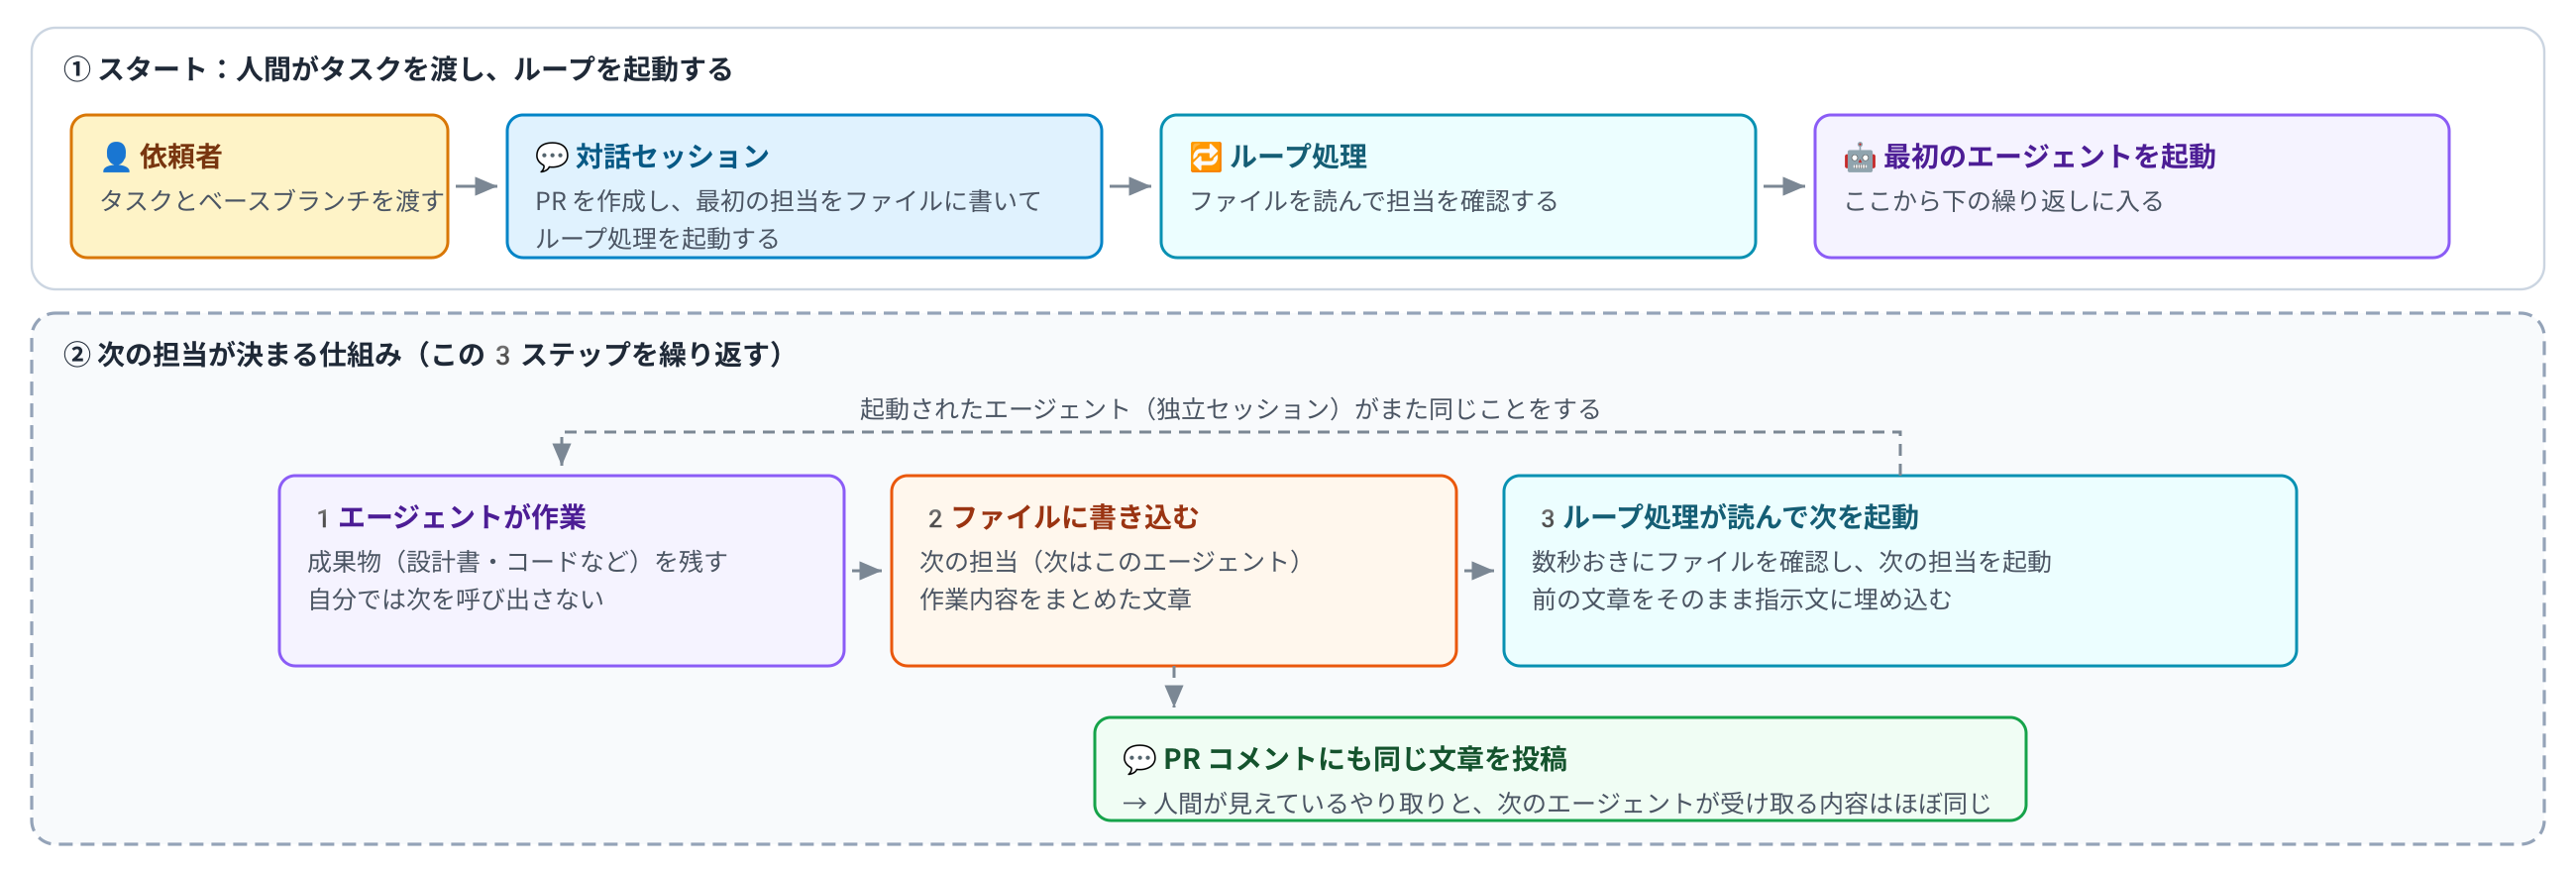
AIエージェントパイプラインは、ほとんどがshellで構成されています。全体を統括するオーケストレーターAIは存在しません。各エージェント間のやりとりは1つのファイルを介して行われます。オーケストレーターAIを常駐させない分、その判断にかかるトークンを消費せずにリレー形式で進行できます。
各エージェントは、自分の作業が終わったら、1つのファイルに書き込みます。書き込む内容は、「次はこのエージェントです」といった次の担当と、作業内容をまとめた文章です。書き込んだあと、そのエージェント自身は次のエージェントを呼び出しません。このファイルを読み取っているのは、bashで書かれた1本のループ処理です。このループは数秒おきにファイルの中身を確認し、次のエージェントが決まっていればそれを起動します。
前のエージェントが書き残した作業内容の文章は、次のエージェントを起動するときに、そのまま指示文へ埋め込まれます。この文章は同時にPRコメントとしても投稿されます。そのため、PR上に見えているやり取りと、次のエージェントが実際に受け取る内容はほぼ一致します。こうして、特別なオーケストレーションのフレームワークを使わずにリレーが成立しています。
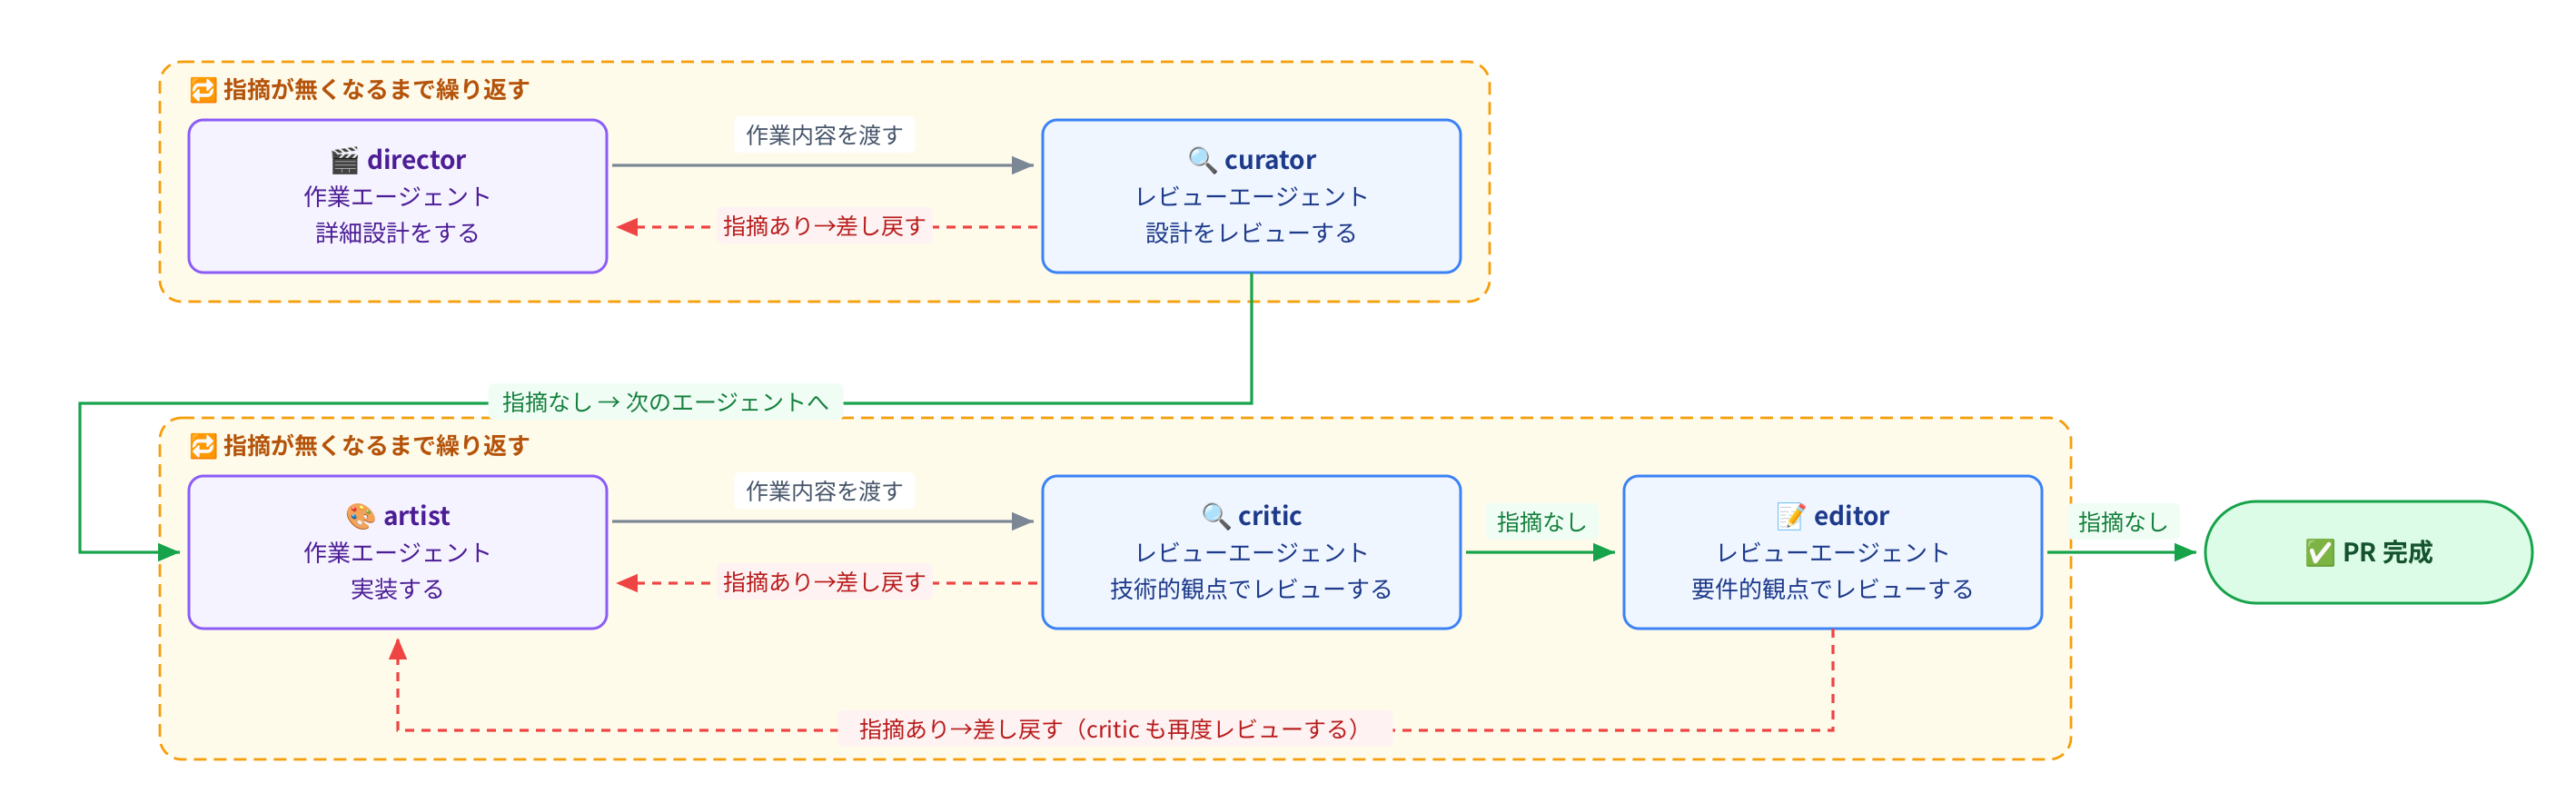
設計や実装を担当するエージェントの成果物は、レビューエージェント(curator・critic・editor)が確認します。問題があれば、1つ前のエージェントに差し戻されます。
各エージェントは一度限りの短いセッションで完結します。そのため再レビュー時は、「前回の指摘が直っていればOK」という主観的な判断にはなりません。都度ゼロベースで他に問題がないかを確認します。
差し戻しは1度で終わるとは限りません。修正されたものは改めてレビューにかけられ、そこでまた指摘が出れば、もう一度前のエージェントへ戻ります。指摘がなくなるまで、この往復が繰り返されます。
単一ではなく複数エージェントによるリレー方式を選んだ理由
単一のAIに全工程を任せず、複数のエージェントに役割を分担させました。人間が実装タスクからPRを作成してレビューを依頼するまでの間に、暗黙的な工程があるからです。工程ごとにエージェントを分けたほうが、AIに無秩序に実装を進めさせるより精度が上がると考えました。役割を分けた結果、各エージェントは前工程の成果物を受け取って作業を進めることになり、リレー形式の進行になっています。
AI導入前も、対話型AIで進めていたときも、人間は実装タスクを次のような順番で進めてPRを作成していることが多いと思います。
- 詳細設計(director): 実装タスクをどのように実装するか、方針を考える
- 実装方針の合意(curator): 考えた方針を自分で見直し、必要なら他のメンバーからレビューをもらう
- 実装(artist): 方針が決まれば実装する。実際に動かして修正し、テストコードを作成する
- 技術的観点でのセルフレビュー(critic): バグや規約の漏れがないか見直し、あれば修正する
- 要件的観点でのセルフレビュー(editor): 作成したPRが本当に要件を満たしているか確認し、漏れがあれば修正する
この5工程を、括弧内の5つのエージェントに1つずつ担当させています。
オーケストレーターAIを置かない理由
人間がAIにタスクを指示する場合、全体を統括するオーケストレーターAIがサブエージェントを起動させる構成をよく見かけます。オーケストレーターAIは会話を通じて進行状況を把握し続けます。そのため、蓄積された文脈を踏まえて毎ターン判断することになります。
今回の構成では、オーケストレーターAIを置きません。bashのループ処理と1つのファイルへの書き込みだけで、次に呼び出すエージェントを機械的に決めています。常駐する判断役のAIを置くと、会話を重ねるうちに判断が主観的になっていくのではないか。そう考え、この設計にしました。各エージェントは一度限りの短いセッションで完結するため、その懸念を避けられます。ただし、オーケストレーターAIを置く構成を実際に試して比べたわけではありません。
AIエージェントパイプライン起動後、PRができるまでに人間がやること
人間が関わるのは、基本的に「最初の実装タスク指示」と「完了後のPRレビュー」だけです。ただし、その間にも人間がやることが2つあります。
1つは、AIからの質問に答えることです。実装タスクの記述が曖昧で複数の解釈ができるなど、自律的に判断できない場面では、人間に質問するフローを用意しています。
もう一つは、停止したAIエージェントパイプラインを起動し直すことです。レビューの指摘が繰り返されてループの設定上限に達すると、AIエージェントパイプラインは自動で停止します。
実際、作成済みのコードを責務ごとに分解・共通化するタスクを依頼した際にこの停止が発生しました。プロダクトコードの分解だけでなく、既存テストコードの移動や、分解に伴うテストコードの追加まで求められる内容だったためです。その結果、技術的な考慮漏れや分解に伴う機能不全が発生し、レビューエージェントの差し戻しが繰り返され、ループ上限に達しました。
このような人間のサポートが必要な場面を除けば、タスクを受け取った後は実装・CI待機・外部レビュー待機・差し戻し対応まで自動で進みます。
実装タスクの書き方:曖昧さを防ぐ指示テンプレート
今回作成したAIエージェントパイプラインは、決まったフォーマットに沿っていない指示でも動作します。しかし、実装タスクを渡す「入力の質」がそのまま成果を左右します。タイトルだけや本文が1〜2行しかない実装タスクでは、本来達成したいこととは違う成果物を生成してしまうことがあります。対話形式ではなく、実装タスクを渡すだけの一方通行になりました。その分、複数の解釈ができる書き方を避け、指示を具体的に書いておく必要があります。
そのため、AIエージェントに渡す実装タスクの指示テンプレートを作成しました。以下の項目で構成されています。
- 背景・目的
- 実現したいこと
- 期待する動作
- 受け入れ条件
- 対象範囲
- 対象外
テンプレート例
実際の実装タスクでは、以下のような記入になります。
# 一覧画面の並び替え(ソート)機能追加

## 背景・目的

一覧画面から目的の対象を探す際、完全一致検索のみでは特定しにくいという要望が寄せられている。名前順・来店回数順に並び替えられるようにすることで、目視での特定を容易にし、対応の判断もしやすくする。

## 実現したいこと

一覧画面に、名前順(あいうえお/ABCの昇順・降順)と来店回数順(昇順・降順)の並び替え機能を追加する。

## 期待する動作

- 一覧画面にソート項目(名前・来店回数)と昇順・降順の切り替えUIを設置する
- ソート処理はフロントエンド側で行う。APIから取得済みの一覧データに対し、選択中のソート項目・順序に応じて並び替えて表示する
- ソートを適用しても、既存の検索・絞り込み条件は維持されたままになる

## 受け入れ条件

- [ ] 名前順(昇順・降順)で並び替えると、あいうえお/ABC順に一覧が表示される
- [ ] 来店回数順(昇順・降順)で並び替えると、来店回数の多い・少ない順に一覧が表示される
- [ ] 検索・絞り込み条件を設定した状態でソートしても、条件が維持されたまま並び替えられる

## 対象範囲

- 対象画面:一覧画面
- 対象機能:名前順・来店回数順の並び替えUIとフロントエンド側のソート処理

## 対象外

- 前方一致検索の強化
- 最終来店日など、ソート対象項目の追加
背景・目的(なぜこのタスクが必要か)
この実装タスクが必要になった案件の要求や、修正・改善の理由を記載します。人間に実装タスクをお願いするときも、案件や実装タスクの背景情報を説明します。
AIも同様です。実装タスクの前提条件や案件全体の話を入れておくと、設計や実装で迷う場面でも、達成したいものに沿って判断できます。その結果、より確度の高い成果物が出ます。
実現したいこと(このタスクで何を変更・追加するか)
背景・目的を踏まえて、この実装タスクで実際にどのような機能や振る舞いを実装したいかを記載します。ここまで具体的に書いておくことで、AIが実装方針で迷わず、目指す振る舞いに沿って判断できます。
期待する動作(画面・API・状態・データの期待値)
実装タスクを実施した結果、システムとしてどのような挙動になるかを記載します。たとえば「検索フォームを設置し、検索ボタン押下でデータ通信してリストを更新する」といった内容です。
実際に、ある画面に項目ごとの並び替え(ソート)機能を追加するタスクがありました。このとき、指示は「並び替え機能を追加する」だけでした。ソート処理をフロントエンド側で行うのか、バックエンド側でAPIにソート条件を渡すのかは明記しませんでした。検証では、この同じ指示で何十回もタスクを繰り返しました。それでも、AIがask-humanで質問を返してきたのは、そのうち1回だけです。残りのほとんどは、AI自身が黙って実装方針を決めて進めてしまいます。
この項目を設けているのは、指示に実装レイヤーを書かず、意図しない実装が進んだ経験があったからです。
テンプレートの「期待する動作」欄に実装レイヤーまで具体的に書けば、この曖昧さは防げます。ただし、人間側でもレイヤーが未決定な場合は、director(詳細設計エージェント)がその曖昧さを検知して人間に確認すべきです。
受け入れ条件(この実装タスクで満たす完了条件)
実装タスクが完了したと判断できる条件を記載します。ここは文章ではなく、チェックリスト形式のテストにします。そうすると、artist(実装エージェント)はチェック表に沿って機能が実装できているかを確認できます。レビューエージェントもチェックリストを満たしているかを二重チェックします。他の関連機能が壊れていないか、類似・別パターンでも満たせているかといった観点も、テストを起点に確認させる狙いです。
対象範囲(対象画面・機能名・API・ファイル・URLなど、今回対応する範囲)
対象となる機能をここで指定することで、AIが関係のないファイルを参照することを防ぎます。また、類似画面や類似機能を見つける手掛かりにもなるため、共通化などを提案してくれることもあります。
対象外(関連するが今回は対応しない範囲)
対象範囲に含めなかった、関連する機能や別タスクで対応予定の変更をここに明記します。関連度の高い機能ほど、AIが指示にない範囲まで踏み込んで手を加えてしまうことがあります。対象範囲とセットで明示しておくことで、意図しない実装を防ぎます。
コストの実態:所要時間とトークン数
計測したのは、実際の案件で作成したPR1本分です。対象タスクは、既存機能の不具合修正でした。同じ機能でも操作のパターンによって挙動が揃っていなかったため、既存コンポーネントの修正で横断的に解消しています。変更行数自体はそこまで多くない(差分:+351行、-1行)ものの、影響範囲を確認するために既存の大きなフックファイルやテストファイルを読み込む必要がありました。レビューの往復も発生しています。
なお、このAIエージェントパイプラインは基本的にClaude Sonnet 4.6で運用しています。以下に示す数値は、すべてこのモデルで実行したときの実測値です。
| 役割 | 合計トークン | 入力 | 出力 | Cache Read(再利用) | Cache Write(新規保存) | Cache Hit率 |
|---|---|---|---|---|---|---|
| director | 7,390,389 | 2,519 | 59,541 | 7,094,870 | 233,459 | 96.8% |
| curator | 2,914,853 | 1,852 | 32,931 | 2,749,122 | 130,948 | 95.4% |
| artist | 5,426,503 | 11,727 | 37,176 | 5,201,808 | 175,792 | 96.5% |
| editor | 1,492,274 | 869 | 10,707 | 1,412,934 | 67,764 | 95.4% |
| critic | 1,784,678 | 2,133 | 14,274 | 1,702,822 | 65,449 | 96.2% |
| 合計 | 19,008,697 | 19,100 | 154,629 | 18,161,556 | 673,412 | 96.3% |
※ キャッシュヒット率は、Cache Read ÷(入力+Cache Read+Cache Write)で算出しています。
上記の表のPRでは、所要時間は約49.5分でした。
トークン数は1,901万でした。AIエージェントパイプラインを起動してから、詳細設計・実装・セルフレビューを経て、人間がレビューできる状態になるまでの合計です。PR作成後に人間から指摘を受けて修正した場合は、その再実行にかかるトークンが別途乗ります。
この1,901万トークンにかかった金額は、約$12でした(※APIの公開価格に基づく概算値です)。前述の通り、変更行数は少なくても、影響範囲の確認に手間がかかるタスクです。それを踏まえると、この金額はPR単体の規模に対して過大ではないと考えています。
加えて、AIエージェントパイプラインが動いている間、人間は待機する必要がなく、他の作業を並行して進められます。その点も含めると、チームとして案件を進めるために払うコストとしては見合っていると考えています。
セッションを短く保つ設計とキャッシュヒット率のトレードオフ
前述の通り、各エージェントは一度限りの短いセッションで完結します。仮に短いセッションに分けず、1つの長いセッションで最初から最後まで対話的に進めていた場合、会話履歴が肥大化し、リクエストごとにその履歴を読み直す分のトークンを消費し続けることになります。Claude Codeの公式ドキュメントには、以下のように記載されています。
A session that has been open for hours can use far more of your plan limits than your activity suggests, usually for one of these reasons: Long context: Claude Code sends your full conversation with every request, and each time Claude uses tools it sends another request carrying that batch of tool results. With prompt caching, Claude Code re-reads that history at the cached token rate, so a one-line question in a session that has been open all day still draws usage for the whole conversation.
—— Claude Code公式ドキュメント「Costs」内 "Why usage climbs in a long session" より(https://code.claude.com/docs/en/costs)
セッションを短く保てば、この履歴の読み直しによるトークンの消費は抑えられます。ただし代償もあります。エージェントごとにセッションを分けると、そのセッションは前のセッションが積み上げたキャッシュを引き継げません。この点も、公式ドキュメントに以下のように記載されています。
A subagent starts its own conversation with its own system prompt and tool set, separate from the parent's. Its first request doesn't read the parent's cache, because the two prefixes differ, and it warms a cache of its own across its turns.
—— Claude Code公式ドキュメント「Prompt caching」内 "Subagents and the cache" より(https://code.claude.com/docs/en/prompt-caching)
このAIエージェントパイプラインで起動されるエージェントは5つで、差し戻しが入ればその回数だけ増えます。エージェントが起動するたびに、新しいセッションは前のセッションのキャッシュを引き継げず、一から積み直すことになります。そのため、対話型よりキャッシュヒット率は下がります。実測ではPRごとにおおむね93%〜98%で推移していました。当初は高い数字だと思っていましたが、1つのセッションでキャッシュを積み上げ続ける進め方なら、もっと上がるはずの数字です。
この設計は、履歴の読み直しを減らす代わりに、キャッシュヒット率を下げています。キャッシュヒット率だけを見れば、履歴を積み上げ続ける対話型のほうが高くなります。ただし対話型は、リクエストのたびに会話全体を読み直すため、キャッシュヒット率が高くても読み直す量そのものは積み上がります。同じタスクを対話型でも実行して比べていないため、案件1本のトークン代としてどちらが安く済むのかは判断できません。
コストだけでは測れない価値
所要時間にもトークン数にも表れない変化は、タスクを渡した人間の負担のほうに出ました。
テンプレートを使う立場になったことで、AIへの指示を出す際に「何を伝えるべきか」「どこまでコンテキストを渡すべきか」を毎回考える必要がなくなりました。
AIエージェントパイプラインはgit worktreeでメインリポジトリと別の作業ディレクトリで動きます。そのため、AIが実装をしている間も手元を自由に使えます。手元で人間の作業を妨げないだけでなく、仕様の調査や他タスクへの指示出しも並行して行えます。AIエージェントパイプラインを何本も同時に走らせられるのもこのためです。
AIエージェントパイプラインは、人間の返答を待たずに最後まで進みます。動いている間は、そのタスクを意識せずに済みます。認知負荷から解放されたという実感がありました。
ただし、この解放感はAIエージェントパイプラインが動いている間だけのものです。指示が曖昧な場合にAIから質問が飛んでくることは稀です。多くの場合、AIが気づかないまま実装を進めてしまいます。そのため、意識せずに済んだ分、PR完成後のレビューで初めて認識のズレに気づくことになります。
それでも、AIエージェントパイプラインが動いている間に他の作業を進める負荷が、対話型で逐一指示を出していた頃より軽くなったことに価値を感じています。
チームで運用してみた実績
このAIエージェントパイプラインは、チームメンバーにも配り、実際の案件で使ってもらっています。
他タスクと並行して進めるのが対話型より容易になった。
私以外のチームメンバーも、対話型よりも実装タスクを並行して進めやすくなったとフィードバックをもらいました。
とはいえ、精度はまだ高くなく、完全に手放しにはできていません。対話型と比べて並行作業の負荷が減ったにとどまっており、その効果も向いている実装タスクに限られます。単純すぎるタスクや、環境依存の判断が絡むタスクでは、逆にAIエージェントパイプラインを使う方が時間がかかることもあります。
結合テストで大量に出た不具合を修正し、スケジュールの遅延を防げた。
AIエージェントパイプラインを導入した直後、担当していた大きな案件が結合テスト期間に入り、想定以上の不具合が報告されました。その中には、人間だけで実装していれば上がってこなかったのではないかと感じるものも混じっていました。AIに実装させた分だけ、不具合の総量そのものが増えていた可能性はあります。
ただ、その修正もAIエージェントパイプラインに任せることができました。報告された不具合を次々に修正させ、人間がレビューしてマージする形で対応した結果、テスト期間中に修正が完了し、スケジュールの遅延を防ぐことができました。
この経験を振り返ると、不具合修正は「何を直すべきか」が明確で、判断基準も定型的な実装タスクです。判断の余地が少ない実装タスクほど、AIの実装精度にばらつきが生まれにくいという気づきを得ました。
人間のレビューで指摘なくマージされたPRがほとんどない。
AIが設計、実装、セルフレビューしたPRがそのままマージできたケースはほとんどありませんでした。前述の通り、レビューエージェントが修正を指示することはあります。しかし、人間の基準には満たないことがほとんどです。
実際、AIエージェントパイプラインのみで人間がそのままマージできたPRは、約2週間で作成した全18件のうち2件、約1割です。
1割という数字は、指摘なしでマージできる水準に遠く及ばないことを示しています。ただし、はじめから指摘がゼロになる精度を目指していたわけではありません。まず目標にしていたのは、チームの実務で使える水準に到達することです。前述の通り、結合テスト期間の不具合修正では案件のスケジュール遅延を防げており、その目標自体は達成できています。そのため、1割という数字は現時点では許容しています。人間の指摘が入る要因は、大きく2つあります。
1つは、人間のレビュアーが持っている「レビュー観点」を、AIのレビューエージェントに渡しきれていないことです。AIが実装段階で処理の重複などのミスを出すこと自体は問題ありません。真の問題は、AI側に人間と同じレビュー観点が不足しているため、実装時のミスを差し戻せずに人間の手元まで通してしまっていることです。
したがって、実装エージェントに完璧なコードを書かせようと調整するよりも、まずは「レビュー観点」を洗い出し、レビューエージェントに教え込むことを優先すべきです。AIは教えられていない観点には決して気づけないため、人間が何を見ているのかを言語化して渡すことが、システム全体の精度を底上げする絶対の前提になります。
もう1つは、指示テンプレートの内容が曖昧だったことです。指示テンプレートの項目を埋めていても、各項目に書いた中身が曖昧だと、director(詳細設計エージェント)はその曖昧さに気づかないまま実装方針を決めてしまいます。前述の並び替え機能の実装タスクもその一例で、こうしたケースは実際に多く発生しています。
テンプレートが効いたのは、何を書けばいいかが分かるという点までです。項目は細かくしてきました。「期待する動作」の欄も、実装レイヤーを書かずに意図しない実装が進んだ経験から足したものです。それでも、ソート処理をどちらのレイヤーで行うかがまだ決まっていなければ、欄があってもそこは埋まりません。
テンプレートを作り込むより先に、書かれていない前提をdirectorに検知させ、人間に質問させたいです。いま、曖昧なまま渡しても、AIが質問を返してくることはほとんどありません。この検知の精度が上がれば、テンプレートの中身が埋まりきっていなくても、実装に入る前に質問が飛んできます。指示文の出来が書き手によってばらつく分を、AIエージェントパイプラインの側で吸収したいと考えています。
人間の指摘を修正するとき、artistだけでなくcriticとeditorが動いた。
人間から指摘を受けた後の修正作業を、AIエージェントパイプラインに行わせるスキルを用意しています。このスキルを使うと、artist(実装エージェント)からAIエージェントパイプラインを動かせます。artistはPRに投稿された指摘コメントを確認して、修正を進めます。
ただし、artist(実装エージェント)が修正を完了した後には、critic(技術的観点レビューエージェント)とeditor(要件的観点レビューエージェント)も動き、レビューを行います。
この起動は指摘の内容によらず一律なので、動かすエージェントを指定する手段は用意していませんでした。レビューの指摘には、1行の修正で済むものや、修正方針まで示されているものもあります。また、修正後には改めて人間が修正内容を確認します。そのため、実装後のレビューは過剰になり、時間とトークンを必要以上に使っていました。
まず、人間の指摘に対してartist(実装エージェント)だけを動かすなど、エージェントを指定して再実行できる仕組みが必要です。そのうえで、どのレビューエージェントを動かすかを人間が都度決めるのではなく、AI自身が判断する仕組みまで持っていきたいと考えています。
まとめ
AIエージェントパイプラインを作成し、実際の案件で運用するようになりました。出発点だったのは「人間の返答待ちがボトルネックになる」という問題です。AIエージェントパイプラインが動いている間、タスクを渡した本人は他の作業を進められます。対話型よりも指示を出す負荷が減り、より多くの作業を並行して進められるようになりました。
ただし、人間の手が要らなくなったとまでは言えません。指摘なしでマージできたPRは18件のうち2件で、残りはPR作成後に人間が指摘し、修正しています。手が残っているのは、最初に渡す指示文と、最後のレビューです。人間がレビューする時の観点をレビューエージェントに渡すこと、指示文に書かれていない前提をAIに検知させて質問させること、この2点に取り組んでいます。
今回踏み込んだのは、案件を実装単位のタスクに分割し終えたあとの工程だけです。渡しているのは、詳細設計より前の、背景・実現したいこと・受け入れ条件だけが決まった状態のタスクで、そこからPR作成までを任せています。前述のレビュー観点の追加、前提の検知に加えて、扱う範囲そのものを広げることも考えています。案件の要求をどう実装単位のタスクに分割するかを決める工程にも、同じ考え方を応用できないか検証していきたいです。
最後に
最後まで読んでいただき、ありがとうございました。この記事が、AIを活用した開発効率化に取り組む皆様の、何らかのヒントになれば幸いです。
食べログでは、一緒に働く仲間を募集しています。
ご興味のある方は、ぜひ採用情報をチェックしてみてください。